NLP och entitetsigenkänning: så fungerar det
Så läser en dator namn i text och tal: NLP och entitetsigenkänning
Från transkription till identifierade personer, organisationer och varumärken. Vad som händer i varje steg, och varför sammanhanget avgör.
NLP är datorns sätt att hantera språk
NLP, naturlig språkbehandling, är ett område inom artificiell intelligens som gör att datorer kan förstå, tolka och generera mänskligt språk. Enligt IBM kombinerar tekniken datorlingvistik, alltså regelbaserad modellering av språk, med statistiska modeller, maskininlärning och djupinlärning.
Det ger vardagliga tillämpningar som översättning, sentimentanalys, chatbottar, röstassistenter, sammanfattning och informationsutvinning. Det svåra är att språk inte alltid är konsekvent. Allt som behövs för att förstå en text finns inte i själva texten. Därför räcker inte grammatik ensam, och moderna system lär sig i stället av stora textmängder. Läs mer i Vad är NLP och hur används det i mediebevakning?.
Entitetsigenkänning gör text till strukturerad data
Entitetsigenkänning, NER (Named Entity Recognition), är en central teknik inom NLP. Den hittar och klassificerar namngivna enheter i text: personer, platser, organisationer, datum, mängder och belopp. De vanligaste typerna är person, plats och organisation.
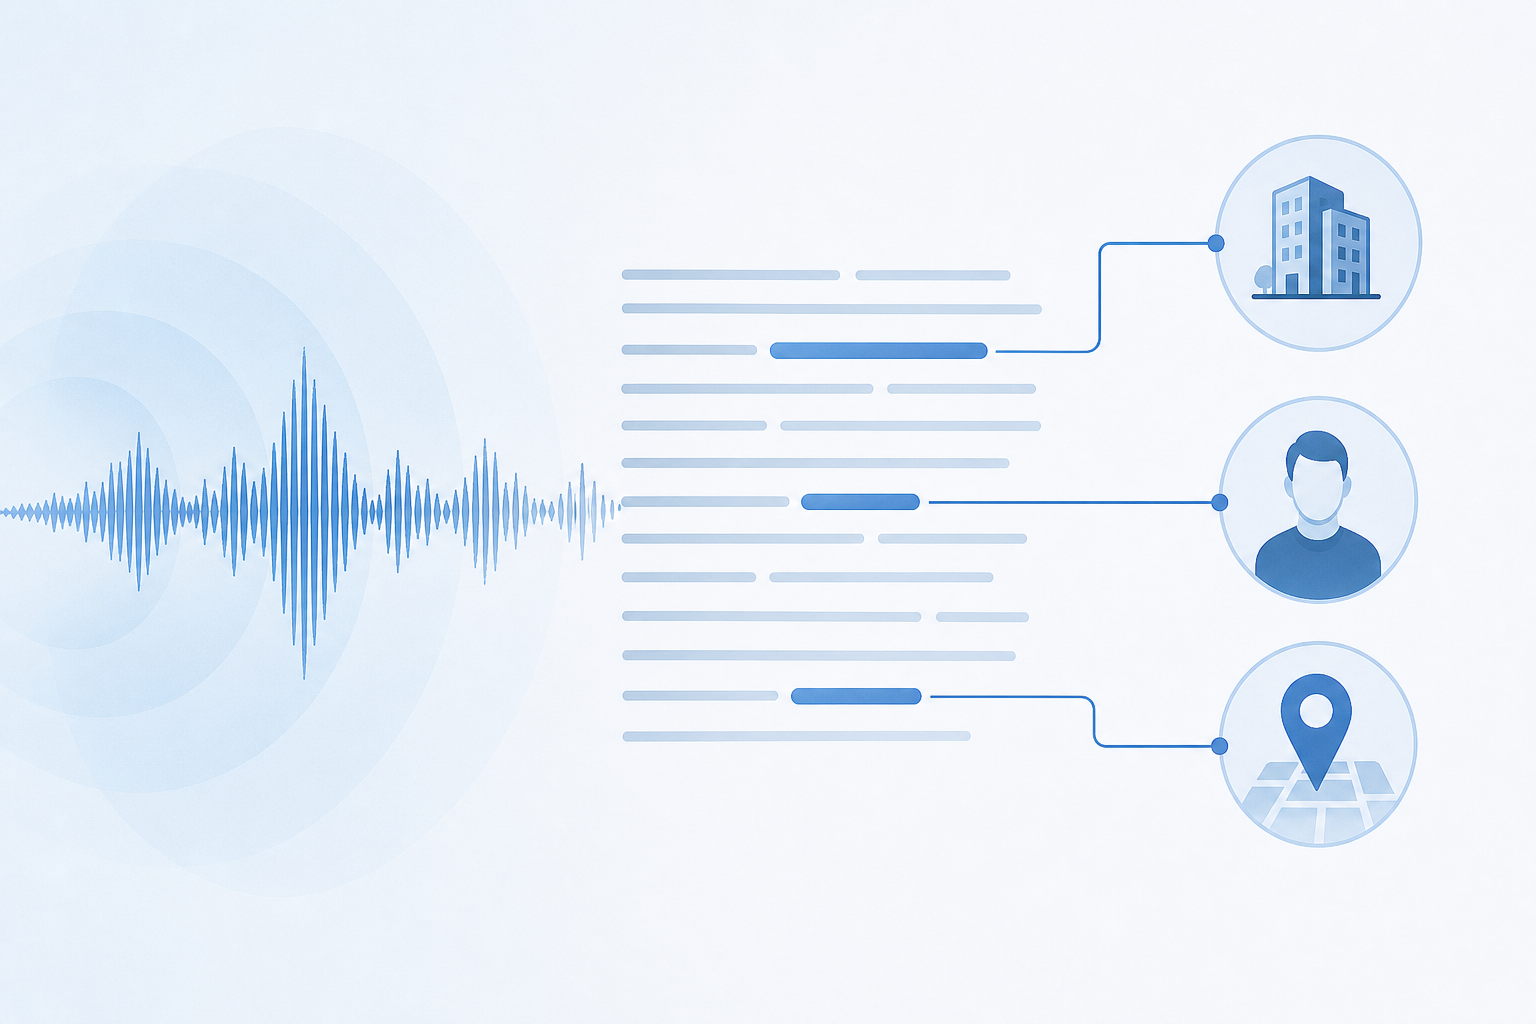
Värdet ligger i att ostrukturerad text blir strukturerad. Ett löpande samtal blir en lista över vem eller vad som nämndes, och var. Det används i sökmotorer, chatbottar och textanalys, och är en viktig förberedelse för informationssökning och frågesvar. För mediebevakning är det själva grunden: utan entiteter vet man inte vilket varumärke ett klipp handlar om. Se även entitetsigenkänning.
Sammanhanget avgör om modellen har rätt
Äldre ansatser bygger på regler och ordlistor: finns ordet i listan är det en träff. Det fungerar för entydiga namn men fallerar när samma ord kan betyda flera saker. Därför görs det mesta av NER-arbetet i dag med neuronnät som tränats på märkt data och lär sig mönster i omgivande text.
En modell som läser hela meningen, och helst hela samtalet, kan avgöra om ett namn syftar på en myndighet, en bank eller en person. Maskininlärning förstår dessutom inte text som sådan. Texten måste omvandlas till tal, och kvaliteten på den omvandlingen och på träningsdata styr resultatet. Generella modeller som tränats mest på andra språk har svårare med nordiska namn, böjningar och dialekter.
Så tillämpar Tonar tekniken på nordiskt ljud
Tonar bevakar poddar, radio, strömmande tjänster, korta klipp och sociala medier i Sverige, Finland och Norge. Först blir ljudet text med egna AI-modeller tränade på nordiska språk, dialekter och verkliga sändningar. Ordfelsfrekvensen ligger på 3 procent, och modellerna är upp till 5 gånger mer exakta än de mest avancerade open source-alternativen.
Sedan läser modellerna hela samtalet och tolkar namn, varumärken och förkortningar rätt. Resultatet används för share of voice, sentiment på entitetsnivå och ämneskopplingar. Fördjupning finns i Mediebevakning verktyg: bästa valen för att mäta share of voice.
Ordfelsfrekvensen ligger på 3 procent, och modellerna är upp till 5 gånger mer exakta än de mest avancerade open source-alternativen.
NER-pipelinen från ljud till varumärke
- 1
Gör ljudet till text
Allt börjar med en transkription. Maskininlärning förstår inte text, så ljudet omvandlas först till ord som sedan kan bearbetas. Fel i transkriptionen följer med in i varje senare steg, så ett felaktigt skrivet varumärkesnamn kan göra att en träff aldrig hittas. Läs om transkriberingsprogram.
- 2
Dela upp texten i tokens
Systemet delar den råa texten i små enheter, tokens, oftast ord eller delar av ord. Det är dessa enheter modellen arbetar med. Böjda former och sammansatta ord, som är vanliga i svenska, gör detta steg viktigare än det låter.
- 3
Märk varje token och bilda entiteter
Modellen sätter en etikett på varje token, till exempel person, plats eller organisation, eller ingen entitet alls. Därefter grupperas märkta tokens till entitetsspann, så att flera ord som hör ihop blir ett enda namn. Etiketterna bygger på mönster modellen lärt sig av märkt träningsdata och på orden runt omkring.
- 4
Koppla entiteten till varumärke och ämne
Till sist tolkas entiteten i sitt sammanhang och kopplas till rätt varumärke, konkurrent eller ämne. Då går det att räkna omnämnanden, mäta share of voice och analysera ton per entitet. Med Auto-label kan ni dessutom beskriva en egen regel med vanlig text, så märks varje träff som matchar. Se sentimentanalys.
Tre situationer där entitetsigenkänning gör skillnad
SCB eller SEB i samma sändning
Två förkortningar som liknar varandra, och som lätt hörs fel i ett ljudklipp. En enkel ordlista eller en svag transkription blandar ihop dem. Modeller som läser hela samtalet ser om det handlar om statistik och siffror eller om bank och räntor, och tolkar rätt. För en kommunikationschef betyder det att bevakningen får med rätt omnämnanden i stället för förväxlade.
Ton mot ett varumärke, inte mot hela klippet
Ett poddavsnitt kan prata positivt om en kampanj och kritiskt om en konkurrent i samma mening. Sentiment på avsnittsnivå ger då ett medelvärde som säger lite om det enskilda varumärket. Med entitetsigenkänning analyseras tonen per entitet, utifrån hur något sägs och inte bara vilka ord som används. Då ser en PR-chef vad som sägs om just det egna varumärket.
Ämnen kopplade till rätt varumärke
Ett konkurrensbevakningsteam vill veta vilka frågor som förknippas med vilka varumärken, till exempel hållbarhet för Max eller kampanjer för McDonald's. När entiteter och ämnen kopplas automatiskt kan teamet jämföra hur varumärken framställs, utan att lyssna igenom allt manuellt. Med AI-sökning beskriver ni vad ni letar efter med egna ord och lyssnar på samtalet med ett klick. Se även bästa programmen för mediebevakning.
Vanliga frågor om NLP och entitetsigenkänning
Se vad som sägs om ert varumärke i ljudet
Vill ni se hur entitetsigenkänning fungerar på era egna varumärken i poddar och radio? Vi visar hur bevakningen ser ut i praktiken.