Vad är NLP och hur används det i mediebevakning?
NLP i mediebevakning: så läser datorer det som sägs
Vad språkteknik är, hur den skiljer namn och ton åt, och varför sammanhanget väger tyngre än ordräkning.
Se NLP arbeta med era egna omnämnanden
Boka en demo och hör hur NLP tolkar era omnämnanden i poddar och radio.
NLP förklarat på ren svenska
NLP, natural language processing, är en gren av artificiell intelligens som gör att datorer kan förstå, tolka och generera mänskligt språk. Tekniken kombinerar språkvetenskap, maskininlärning och djupinlärning för att behandla både text och tal.
Vanliga användningar är översättning, sentimentanalys, chattbotar, röstassistenter, sammanfattning, stavningskontroll och att plocka ut information ur dokument. Det som är gemensamt: en dator ska utvinna mening ur språk, inte bara lagra det. I mediebevakning är det skillnaden mellan en hög med text och något ni kan fatta beslut på.
Regelbaserat eller maskininlärning, och varför det spelar roll
De första NLP-systemen var enkla if-then-träd med förprogrammerade regler. Regelbaserade metoder bygger på manuellt skrivna språkregler, lexikon och mönstermatchning. De fungerar i strukturerade miljöer, men kräver ständiga uppdateringar när språket förändras och har svårt med tvetydig eller sammanhangsberoende text.
Maskininlärning går åt andra hållet. Systemet tränas på stora mängder annoterad språkdata, lär sig mönstren och förbättras ju mer data det ser. Det hanterar slang, tvetydighet och skiftande sammanhang bättre, och just det präglar riktig mediebevakning. Hybrida system, som kombinerar regler och inlärning, ger ofta bättre resultat än någon av metoderna ensam.
Det NLP faktiskt gör i mediebevakning
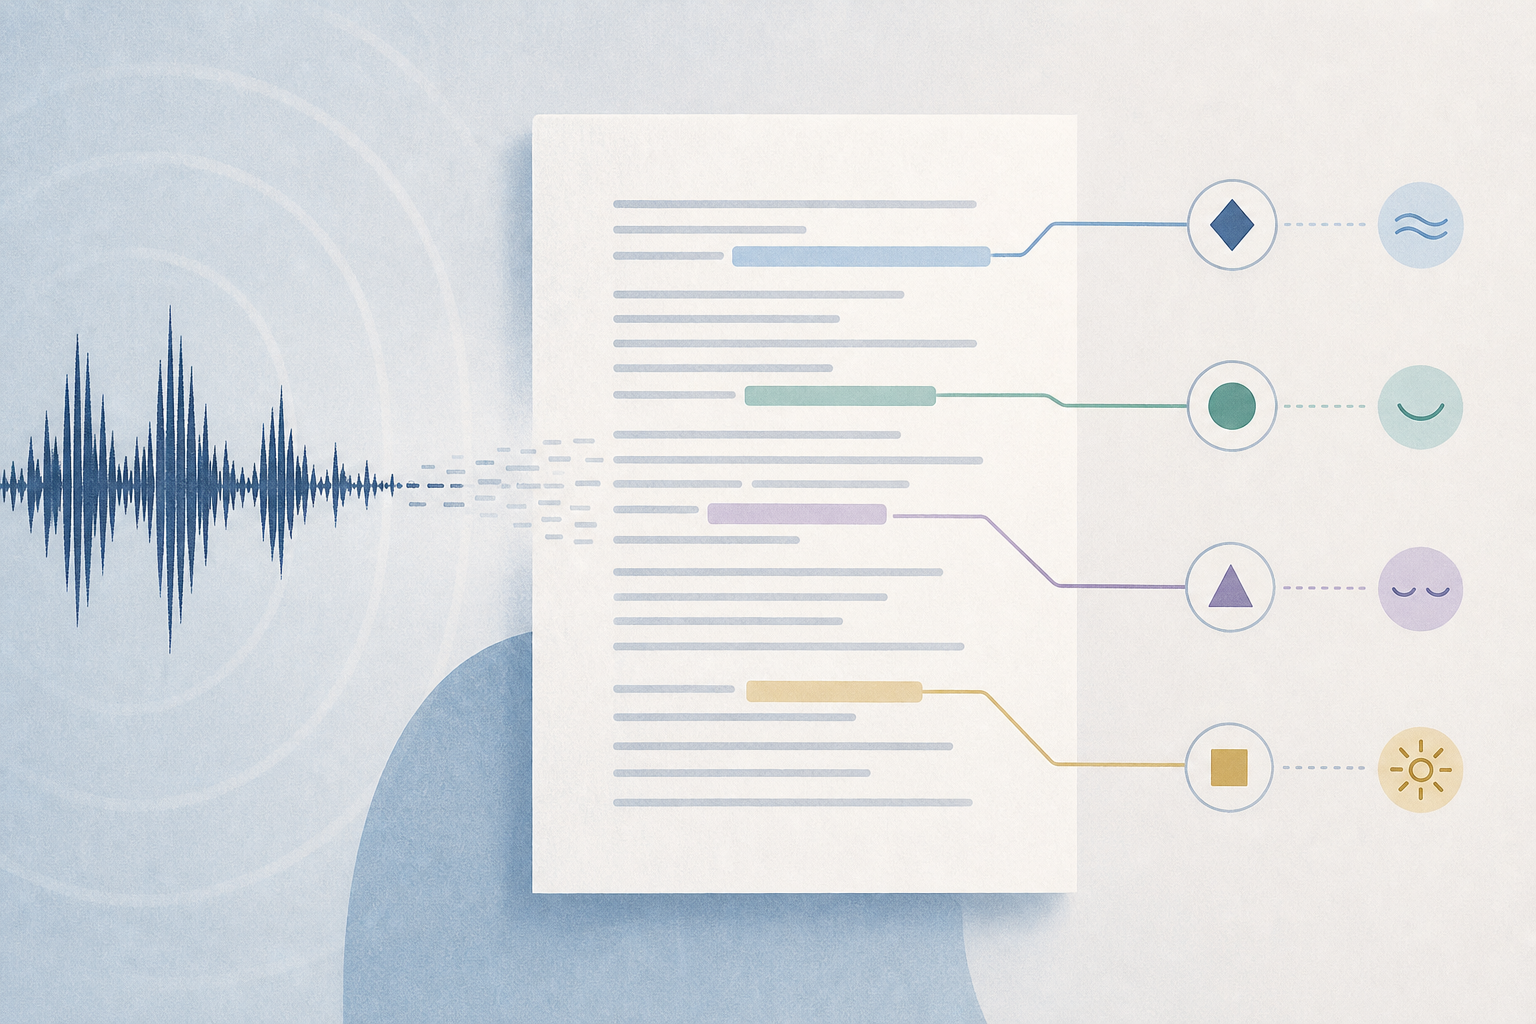
Ett NLP-system går igenom stora volymer material och gör fyra saker. Det hittar omnämnanden av varumärken, personer och ämnen. Det avgör om tonen är positiv, negativ eller neutral. Det klassificerar innehållet efter ämne. Och det flaggar tidiga trender snabbare än manuell genomgång hinner.
Entitetsigenkänning är grunden: systemet måste veta vem eller vad som avses. Vi går djupare i det på sidan om entitetsigenkänning. Sentimentet blir användbart först när det kopplas till rätt entitet, annars säger det bara något om texten i stort.
Hur Tonar tillämpar NLP på ljud
Ljud har ett extra steg: först måste talet bli text. Våra egna modeller är tränade på nordiska språk, dialekter och verkliga sändningar, med en ordfelsfrekvens på 3 procent. Sedan läser de hela samtalet, så att SCB och SEB inte blandas ihop.
Sentimentet analyserar vi på entitetsnivå utifrån tonen, inte bara utifrån positiva eller negativa ord. Vi kopplar också ämnen till varumärken, som hållbarhet för Max eller kampanjer för McDonald's. Med Auto-label skriver ni en regel med vanlig text, och AI:n märker varje träff som matchar.
Ett ord säger lite. Samtalet runt omkring säger vem som menas och hur det låter.
Fördelar
Snabbhet i stora volymer
NLP går igenom material och flaggar trender långt snabbare än manuell genomgång. Ni reagerar medan samtalet pågår, inte efteråt.
Precision genom sammanhang
Modeller som läser hela samtalet tolkar namn och förkortningar rätt, till exempel SCB och SEB. Sentiment på entitetsnivå visar vem tonen faktiskt gäller.
Skalbarhet utan fler regler
Regelbaserade system kräver ständiga uppdateringar. Maskininlärning anpassar sig när den ser mer data, så bevakningen växer utan att någon skriver om reglerna.
Förståelse för nordiska språk
Våra modeller är tränade på nordiska språk, dialekter och riktiga sändningar. Det ger en ordfelsfrekvens på 3 procent.
Tre situationer där NLP gör skillnad
PR-chef som följer tonen under en kris
När ett varumärke diskuteras i poddar och radio efter en incident räcker det inte att veta att antalet omnämnanden ökar. Med sentimentanalys på entitetsnivå ser PR-chefen om kritiken riktas mot just ert varumärke eller mot branschen i stort. Med Auto-label kan en regel som "Märk när någon uttrycker direkt kritik mot vårt varumärke" samla de träffarna, och ett klick låter er lyssna på själva samtalet.
Byrå som jämför share of voice åt kunder
En byrå som bevakar flera kunder och deras konkurrenter behöver att namn tolkas rätt, annars blir siffrorna fel. Entitetsigenkänning ser till att rätt bolag räknas, och ämnesanalys visar vilka teman som kopplas till vilket varumärke. Resultatet är en jämförelse som går att stå för i kundmötet.
Produktteam som bygger en dashboard via API
Ett medieföretag eller produktteam vill visa nordisk ljuddata i sin egen tjänst. Via Tonar API väljer de mellan full databas-firehose, REST API eller RSS-flöde. Ljud- och videodata kommer direkt via API:et, så teamet kan lägga tiden på själva dashboarden.
Vanliga frågor om NLP och mediebevakning
Låt oss visa NLP på era omnämnanden
Vill ni se hur språkteknik fungerar på era egna omnämnanden? Vi visar hur Tonar tolkar poddar och radio i Sverige, Finland och Norge.