Transkribera podcast
Podcasttranskribering som hittar namnen ni letar efter
AI-modeller tränade på nordiska språk ger text ni kan söka i, analysera och lita på.
Testa transkribering som klarar nordiska poddar
Se hur era egna varumärken och konkurrenter låter när poddarna transkriberats med 3 procents ordfelsfrekvens.
Därför missar vanliga verktyg era varumärken
En transkribering kan se hel ut och ändå vara oanvändbar. Om varumärkesnamnet blir fel går det inte att söka fram. Då försvinner omnämnandet, trots att det sades högt i avsnittet.
Generiska verktyg är sällan byggda för nordiska språk och dialekter. De kan blanda ihop förkortningar, stava egennamn på sitt eget sätt och tappa sammanhanget. Följden blir manuell efterputsning, eller värre: att ingen märker att en konkurrent nämndes i ett avsnitt för flera veckor sedan. Då blir poddar en blind fläck i bevakningen.
Modeller som förstår hela samtalet
Våra AI-modeller är tränade på nordiska språk, dialekter och verkliga sändningar. Vi stöder bland annat svenska, norska och finska. Ordfelsfrekvensen ligger på 3 procent, och modellerna är upp till 5 gånger mer exakta än de mest avancerade open source-alternativen.
Modellerna läser hela samtalet, inte bara enskilda ord. Därför tolkas namn, varumärken och förkortningar rätt, till exempel när SCB och SEB annars hade blandats ihop. Läs mer om hur det fungerar i vår språkteknologi och om ljud till text.
Text som går direkt in i analysen
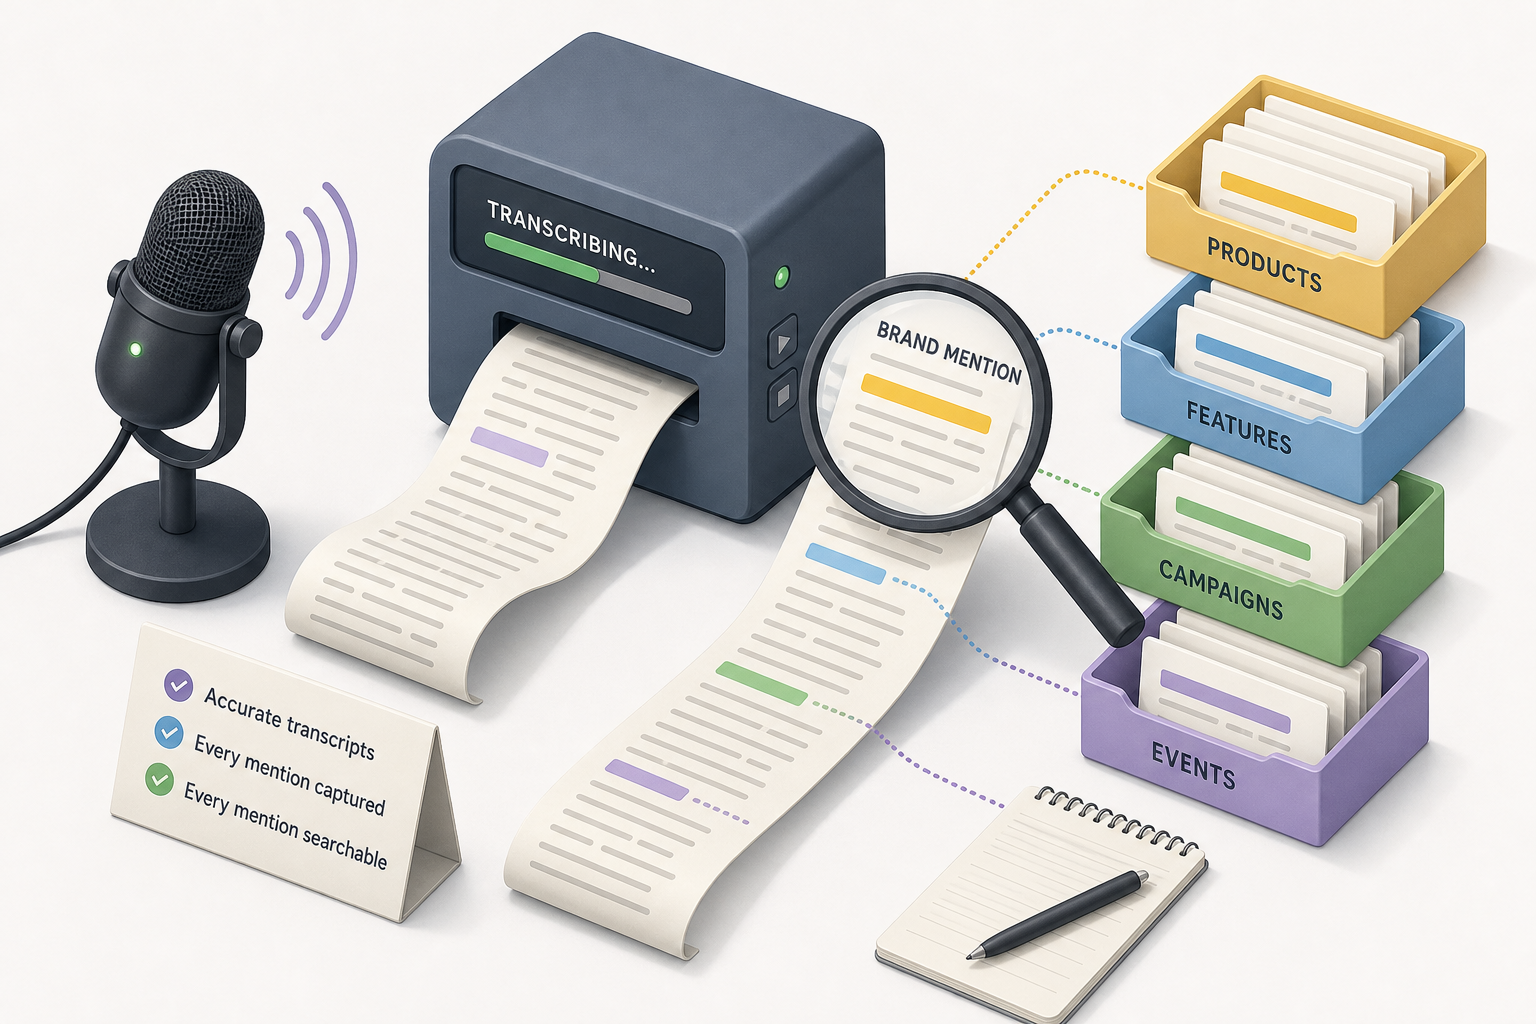
Transkriptionen är inte en fil ni ska bearbeta vidare. Den matas direkt in i omnämnandebevakning, sentimentanalys och sökning. Podcastinnehållet blir fullt analyserbart utan manuell granskning.
Sentimentet analyseras på entitetsnivå utifrån tonen, och ämnen kopplas till varumärken. Med AI-sökning beskriver ni med egna ord vad ni letar efter och lyssnar på själva samtalet med ett klick. Så kan ni kontrollera källan innan ni drar en slutsats.
- Ordfelsfrekvens på 3 procent på nordiska språk.
- Upp till 5 gånger mer exakta än de mest avancerade open source-alternativen.
- Kontextmedveten korrigering av varumärkesnamn, personer och förkortningar.
- Bevakning av ljudmedier i Sverige, Finland och Norge, med stöd för bland annat svenska, norska och finska.
Från poddavsnitt till analys i tre steg
- 1
Podden fångas upp
Tonar bevakar ljudmedier på flera plattformar i Sverige, Finland och Norge och följer omnämnanden av ert varumärke och era konkurrenter i poddar.
- 2
AI transkriberar och korrigerar
Modeller tränade på nordiska språk gör om ljudet till text med 3 procents ordfelsfrekvens. Namn, varumärken och förkortningar tolkas utifrån hela samtalet, så att SCB inte blir SEB.
- 3
Insikterna visas i plattformen
Transkriptionen kopplas direkt till omnämnanden, sentiment och share of voice. Ni söker med egna ord, märker träffar med Auto-label och lyssnar på originalklippet med ett klick.
Fördelar
Slut på manuell granskning
Ni slipper skumma transkript på morgonen. Texten är korrigerad redan när den kommer in, så ingen putsar stavningen av varumärken i efterhand.
Färre missade omnämnanden
När namn och förkortningar tolkas rätt går de att söka fram. Ett omnämnande av en konkurrent försvinner inte lika lätt i en felstavning.
Insikter utan väntan
Transkriptionerna matas direkt in i bevakning, sentiment och sökning. Ni behöver inte vänta på en separat leverans innan analysen kan börja.
Underlag ni kan försvara
Med 3 procents ordfelsfrekvens och möjlighet att lyssna på källan med ett klick kan ni backa upp slutsatserna i mötet, inte bara hänvisa till text.
Vanliga frågor om podcasttranskribering
Sluta gissa vad som sades i poddarna
Berätta vilka varumärken och konkurrenter ni vill följa, så visar vi hur era poddar ser ut som sökbar och analyserad text. Ni kan lyssna på källan när ni vill.